Das passende Training Kubernetes Advanced Training – Networking, Security, Observability & GitOps (3 Tage)
Datenbank im Cluster: Die Operator-Frage kommt zu früh
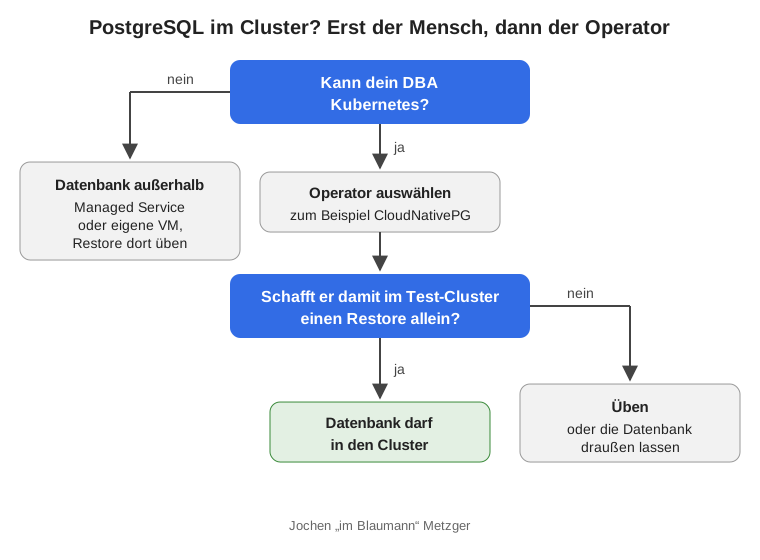
Kurze Antwort: Bevor du CloudNativePG, Zalando und Crunchy gegeneinander antreten lässt, frag was anderes. Kann dein Datenbankadministrator Kubernetes?
Nein? Dann läuft deine PostgreSQL-Datenbank außerhalb des Clusters. Managed Service beim Cloud-Anbieter oder die VM, die er seit Jahren kennt. Ja? Dann reden wir über Operatoren. Meiner heißt CloudNativePG.
Falls dir das Wort noch nichts sagt: CloudNativePG, Zalando und Crunchy sind drei Operatoren für PostgreSQL. Ein Operator ist ein Programm, das im Cluster neben deiner Datenbank läuft und ihren Betrieb übernimmt. Er richtet die Datenbank ein, schaltet bei einem Ausfall automatisch auf eine Kopie um und kümmert sich um die Backups. Du kannst ihn dir vorstellen wie einen Datenbankadministrator, der als Programm läuft und nie Feierabend hat.
Installiert ist nicht betrieben
Im Einführungstraining installieren wir MariaDB per Helm. Dabei fragt ein Teilnehmer: Gibt’s da gar kein Deployment und kein ReplicaSet? Nur Pods?
Super Frage. Da steckt ein StatefulSet drin, und das erzeugt seine Pods selbst, ganz ohne ReplicaSet.
Und genau da liegt der Hund begraben. Die Datenbank ist schneller installiert, als die Frage beantwortet ist, was da eigentlich läuft. Im Training ist das völlig okay, denn dort klären wir gemeinsam, was dahintersteckt. In der Produktion heißt es: Installieren kann jeder. Betreiben ist eine andere Liga.
Kubernetes ist keine eierlegende Wollmilchsau. Backup und Restore musst du dort neu denken. Und bei einer Datenbank zählt am Ende vor allem eins: dass du sie zurückbekommst.
Warum der DBA und nicht “das Team”
Die übliche Antwort lautet: Kubernetes- und PostgreSQL-Wissen gehören ins Team. Selbst die FAQ von CloudNativePG wünscht sich DBAs, die die Kubernetes-Grundkonzepte kennen, und empfiehlt sogar die CKA-Zertifizierung. Als Rat, nicht als Bedingung. Ist mir zu weich.
Bei mir ist das keine Kür, sondern Bedingung. Denn irgendwo im Team hilft dir nachts um drei gar nichts. Stell dir vor, die Datenbank hakt. Dein DBA macht das Terminal auf. Kein vertrautes PostgreSQL. Sondern Pods, PersistentVolumeClaims, ein Cluster-Objekt. Der Failover läuft zwar automatisch. Aber hängt er, muss jemand sehen, welcher Pod gerade Primary ist und wohin der Service zeigt. Und der Restore? Mit CloudNativePG ist das ein neues Cluster-Objekt, das er selbst anlegt. Alles Kubernetes.
Und die typische Aufteilung? Der Plattform-Kollege kann Kubernetes, aber kein PostgreSQL. Der DBA kann PostgreSQL, aber kein kubectl. Die Datenbank liegt genau dazwischen. Wie ein Paket, das beim Nachbarn abgegeben wurde, und beide Nachbarn sind im Urlaub.
Deshalb meine Regel: Kann der DBA kein Kubernetes, gehört die Datenbank nicht in den Cluster. Nicht, weil Kubernetes für Datenbanken schlecht wäre. Sondern weil der Mensch, der sie retten soll, dort nicht zu Hause ist.
Der Operator nimmt dir viel ab, aber nicht alles
Ein guter Operator ist ein Segen. Was er tut, steht im Artikel Helm oder Operator: Failover, Backups, Betriebswissen in Software gegossen.
Er automatisiert Failover und Backup. Wo er nicht weiterkommt, braucht es einen Menschen, der Kubernetes lesen kann. Nachts. Mit der Produktionsdatenbank im Nacken.
Der Prüfstein: ein Restore, allein
Kann dein DBA Kubernetes, kommt der Ernstfall-Test. Test-Cluster, der Operator, den ihr in Produktion nehmen wollt, ein echtes Backup. Aufgabe: Datenbank wiederherstellen. Ohne Plattform-Kollegen daneben.
Schafft er das, darf die echte Datenbank umziehen. Schafft er es nicht, gibt es zwei ehrliche Wege. Entweder er übt, bis es sitzt. Oder die Datenbank bleibt draußen.
Draußen ist keine Niederlage. Deine Anwendungen laufen trotzdem im Cluster und sprechen die Datenbank übers Netz an. Das ist kein halbes Kubernetes, das ist eine Entscheidung mit offenen Augen. Den Restore üben musst du draußen übrigens genauso, nur eben in einer Umgebung, die dein DBA kennt.
| CloudNativePG, Stand 7. Oktober 2026 | Quelle |
|---|---|
| Sandbox-Projekt der Cloud Native Computing Foundation | README im Repository |
| Aktuelle Version 1.30.1 vom 23. September 2026 | Release-Seite von CloudNativePG |
Automatischer Failover: Eine Replica wird Primary, der Service -rw zeigt danach auf sie | CloudNativePG-Doku, Architektur |
| Restore startet einen neuen Cluster aus dem Backup, nicht an Ort und Stelle; Zeitpunkt-Wiederherstellung braucht ein WAL-Archiv | CloudNativePG-Doku, Recovery |
| Backup in einen Objektspeicher: für neue Installationen über das separate Barman-Cloud-Plugin, die eingebaute Variante soll mit 1.31 entfallen | CloudNativePG-Doku, Release Notes 1.30 |
Meine klare Ansage
Die Operator-Frage ist die zweite Frage, nicht die erste. Zuerst kommt der Mensch, der nachts um drei die Datenbank zurückholt. Und wer nachts um drei zum ersten Mal kubectl tippt, tippt langsam.
Kann dein DBA Kubernetes und hat den Restore geübt, nimm CloudNativePG und hab Spaß damit. Wenn nicht, lass die Datenbank draußen, üb den Restore dort und schlaf ruhiger.
Wie Backup, Restore und der Betrieb nach dem ersten Cluster aussehen, üben wir im Kubernetes Advanced Training am eigenen Live-Cluster. Da darf auch mal was kaputtgehen. Mit Absicht.