Das passende Training Kubernetes Networking Training – 3 Tage Praxis & Debugging
Ein Ingress-Controller pro Kunde: Sicherheitsentscheidung, nicht Technik
Ganz ehrlich: Fürs Routing brauchst du ihn nicht. Ein einziger Ingress-Controller verteilt den Verkehr für zehn Kunden genauso gut wie für einen.
Trotzdem bekommt bei mir jeder Kunde seinen eigenen, sobald die Kunden einander nichts angehen. Mein Grund sind die Logs: Ein gemeinsamer Controller schreibt die Anfragen aller Kunden in dieselben Pod-Logs. Getrennte Controller heißt: Jeder Kunde hat sein eigenes Log.
Gesehen bei einem Konzern
Bei einem großen Konzern, den ich geschult habe, hatte jeder Kunde seinen eigenen Ingress-Controller. Technisch nötig war das nicht, Kubernetes hindert dich da an nichts. Der Grund war Sicherheit: Die Logs unterschiedlicher Kunden sollten nicht im selben Pod landen.
In den Vergleichen, die ich dazu finde, geht’s um Features und Performance. Dass „einer oder mehrere?" eine Sicherheitsfrage ist, kommt da kaum vor.
Was ein gemeinsamer Controller ins Log schreibt
Ich zeige es an Traefik. ingress-nginx ist seit März 2026 eingestellt und bekommt keine Sicherheitsupdates mehr. Im Training empfehle ich inzwischen Traefik oder HAProxy.
Der Aufbau, nachgestellt in einem Test-Cluster (kind, Kubernetes v1.37.0, Traefik v3.7.13 per Helm-Chart 41.6.1): ein Traefik im Namespace traefik, dahinter zwei Kunden in den Namespaces kunde-a und kunde-b, jeder mit eigenem Ingress. Drei Anfragen, dann ein Blick ins Log (Auszug):
$ kubectl -n traefik logs deploy/traefik
127.0.0.1 - - [06/Oct/2026:18:14:15 +0000] "GET /bestellung/4711 HTTP/1.1" 200 431 "-" "-" 2 "kunde-a-shop-kunde-a-example-test@kubernetes" "http://10.244.0.6:80" 22ms
127.0.0.1 - - [06/Oct/2026:18:14:15 +0000] "GET /login HTTP/1.1" 200 422 "-" "-" 3 "kunde-b-portal-kunde-b-example-test@kubernetes" "http://10.244.0.7:80" 22ms
127.0.0.1 - - [06/Oct/2026:18:14:15 +0000] "GET /warenkorb HTTP/1.1" 200 425 "-" "-" 4 "kunde-a-shop-kunde-a-example-test@kubernetes" "http://10.244.0.6:80" 21ms
In jeder Zeile stehen die Absender-IP (im Test 127.0.0.1, die Anfragen kamen per Port-Forward), der Pfad und der Name der Route. Der beginnt mit dem Namespace des Kunden. Kunde A und Kunde B stehen also abwechselnd im selben Pod-Log, mit allem, was bei ihnen aufgerufen wird.
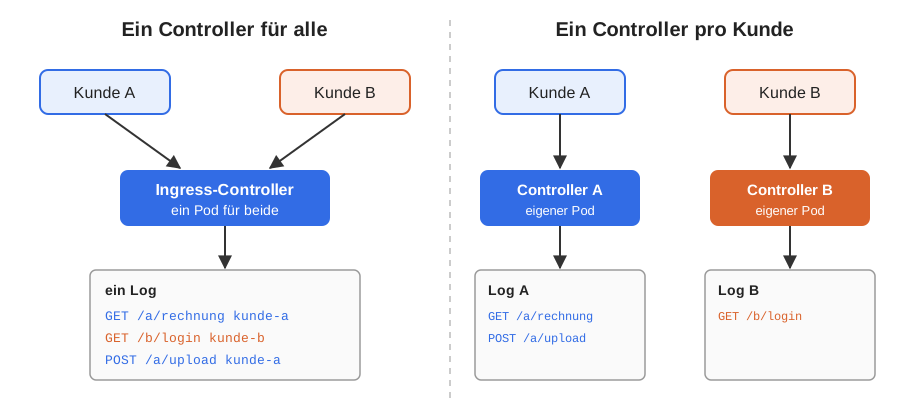
Zur Einordnung: Von Haus aus schreibt Traefik dieses Zugriffslog gar nicht. Im Helm-Chart schaltest du es mit accessLog.enabled=true ein. Nur: Wer wissen will, wer wann was aufgerufen hat, schaltet es ein. Und ab da stehen alle Kunden drin.
Lesen kann das jeder, der im Namespace des Controllers kubectl logs ausführen darf. Dazu jeder mit Zugriff auf die Nodes oder euer Log-System.
Getrennt heißt: eigener Namespace, eigene Rechte
Zweiter Aufbau im selben Cluster: je ein Traefik in kunde-a und in kunde-b, per Helm-Chart mit rbac.namespaced=true. Damit beobachtet jeder Traefik nur noch seinen eigenen Namespace.
Das Ergebnis im Test: Jede Anfrage steht nur im Log des eigenen Controllers. Den Host von Kunde B bedient der Traefik von Kunde A nicht, da kommt ein 404. Und die Leserechte auf die Logs vergibst du pro Namespace, also pro Kunde.
Ein eigener Controller allein reicht dafür nicht. Er gehört in den Namespace des Kunden und darf nur dort hinschauen. Ohne diese Einschränkung beobachtet Traefik laut Doku alle Namespaces.
Was dich die Trennung kostet
Umsonst ist das nicht. Jeder zusätzliche Controller braucht eigene Pods mit CPU und RAM, will bei jedem Update mitgezogen werden und braucht einen eigenen Einstiegspunkt. Bekommt jeder Controller seinen eigenen Service vom Typ LoadBalancer, heißt das: eine IP pro Kunde.
In der Cloud klingt die IP pro Kunde nach Kleingeld. On-Prem kann’s zäh werden. In einem Firmentraining hat mir ein Teilnehmer von einem Mittelständler mit eigenem Rechenzentrum erzählt, dass er jede öffentliche IP einzeln bei seinem Provider beantragen muss. Arbeitest du so, willst du einen Einstiegspunkt, nicht zehn.
Darum lautet die Frage nicht: „Kann ein Controller das?" Kann er. Die Frage lautet: Darf Kunde A im selben Log stehen wie Kunde B?
Wenn nein: eigener Controller pro Kunde, im eigenen Namespace. Sind alle Mandanten Teams derselben Firma, lesen dieselben Admins die Logs sowieso und legt das Plattformteam die Ingress-Objekte an: Einer reicht, spar dir die IPs.
Und mit Gateway API?
Jetzt kommt garantiert einer um die Ecke: „Gateway API! Ein Gateway pro Namespace, Problem gelöst." Anlegen kannst du das so. Ob hinter jedem Gateway auch ein eigener Proxy mit eigenem Log läuft, hängt davon ab, welche Implementierung du einsetzt. Das will ich erst in einer Teststellung sehen, bevor ich’s unterschreibe.
Ein Blick in die Doku zeigt schon, warum ich da vorsichtig bin:
| Variante | Wo laufen die Proxys? | Quelle |
|---|---|---|
| Ein gemeinsamer Ingress-Controller | Dieselben Controller-Pods für alle Kunden, Namespace des Kunden steht mit in der Log-Zeile | Eigener Test, Traefik v3.7.13 |
| Ein Ingress-Controller pro Kunde, je in einem eigenen Namespace | Je Kunde eigene Controller-Pods | Eigener Test, Traefik v3.7.13 |
| Envoy Gateway, Standard | Ein eigener Envoy-Proxy je Gateway, aber alle im Namespace des Controllers (meist envoy-gateway-system) | Envoy-Gateway-Doku, Deployment Mode |
| Envoy Gateway, Gateway Namespace Mode | Envoy-Proxy im Namespace des jeweiligen Gateways | Envoy-Gateway-Doku, Gateway Namespace Mode |
| Envoy Gateway mit mergeGateways | Gemeinsame Envoy-Proxys für alle Gateways der GatewayClass | Envoy-Gateway-Doku, Deployment Mode |
| Cilium | Verkehr aller Gateways läuft durch einen gemeinsamen Envoy pro Node | Cilium-Doku, Gateway API Support |
Bei Cilium hat also jeder Kunde sein eigenes Gateway. Bearbeitet wird der Verkehr aller Kunden auf jedem Node aber vom selben Envoy. Wo der seine Logs hinschreibt und wer sie lesen darf, gehört genau in diese Teststellung.
Meine klare Ansage
Ein gemeinsamer Ingress-Controller ist kein Technikfehler. Ein gemeinsames Log über Kundengrenzen hinweg ist ein Sicherheitsproblem, sobald die Kunden einander nichts angehen. Entscheide nach den Logs, nicht nach der Technik. Und bei Gateway API: erst nachsehen, wo die Proxys laufen und wer ihre Logs lesen darf.
Wie Services und Ingress-Controller zusammenspielen und wo der Verkehr deiner Kunden wirklich durchläuft, üben wir im Kubernetes Networking Training am Live-Cluster.