Das passende Training Kubernetes Advanced Training – Networking, Security, Observability & GitOps (3 Tage)
Der HPA kann mehr als CPU, nur nicht von allein: KEDA oder eigener Controller?
Kurze Antwort: Ja, der HPA kann nach Datenbank-Backlog skalieren. Aber nur, wenn ihm jemand die Zahl hinlegt.
Liegt sie schon über die Metrik-API im Cluster, reicht der Standard-HPA. Liegt sie nicht da, ist KEDA der einfachste Weg. Und kann dein Team Controller schreiben, baust du dir lieber einen eigenen. Der ist schlanker als jedes Zusatzwerkzeug.
Die Frage aus dem Training
Ende September, Einführungstraining. Ein Teilnehmer will wissen: Kann der Autoscaler auch auf was anderes hören als CPU? Bei ihnen stapeln sich Datensätze in einer Datenbank. Werden es besonders viele, soll ein zweiter Pod hochfahren.
Gute Frage. Die CPU muss davon nämlich nichts merken. Ein Pod kann gemütlich vor sich hin arbeiten, während sich hinter ihm die Arbeit bis unter die Decke stapelt.
Meine Antwort im Training: Von allein kann der Standard-HPA das nicht. Nimm KEDA mit einem ScaledObject und einem Trigger, zum Beispiel über Prometheus. Oder bau dir einen eigenen Controller.
Den letzten Satz sagt kaum einer. Dazu gleich.
Was der HPA wirklich kann
Ganz ehrlich: Der HPA ist kein Hellseher, sondern ein Thermostat. Er regelt nach dem Thermometer, das an der Wand hängt. Hängt da keins für deinen Backlog, kann er danach auch nicht regeln.
Und der Thermostat kann mehr, als die meisten glauben. Neben CPU und Speicher versteht er auch eigene und externe Metriken. Nur aufhängen muss die Thermometer jemand anders. Er liest an genau drei Stellen ab:
| Was der HPA abfragt | Wer die Zahl liefert |
|---|---|
metrics.k8s.io (CPU, Speicher) | Metrics Server, ein Add-on; oft schon dabei, sonst nachinstallieren |
custom.metrics.k8s.io (Metriken zu Kubernetes-Objekten) | ein Adapter, zum Beispiel der Prometheus-Adapter |
external.metrics.k8s.io (Zahlen, die zu keinem Kubernetes-Objekt gehören, etwa ein Datenbank-Backlog) | ein Adapter, zum Beispiel der KEDA-Metrik-Server |
Quelle: Kubernetes-Doku zum Horizontal Pod Autoscaling.
Was heißt „extern“? Die Zahl gehört zu keinem Kubernetes-Objekt. Die API-Referenz nennt sie „a global metric that is not associated with any Kubernetes object“. Eine eigene Metrik hängt dagegen an etwas im Cluster, etwa Anfragen pro Sekunde je Pod. Dein Backlog gehört zu keinem Pod und keinem Objekt, darum ist er für den HPA extern.
Hängt deine Zahl da schon? Dann reicht der Standard-HPA.
Wann KEDA
KEDA nimmst du, wenn die Zahl im Cluster gar nicht als Metrik ankommt. KEDA ist dann der Heizungsbauer im Komplettpaket. Er schraubt das Thermometer an, baut den Thermostat ein und bedient den Hauptschalter selbst. Heißt: KEDA fragt die Quelle selbst ab, und laut KEDA-Doku legt der keda-operator den HPA für dich an. Das Hoch- und Runterfahren zwischen null und einem Pod macht er ganz allein. Kein Alleinstellungsmerkmal mehr, übrigens: Seit Kubernetes 1.37 darf laut Kubernetes-Blog auch der Standard-HPA mit Object- oder External-Metriken auf null gehen. Das Feature HPAScaleToZero ist dort Beta und standardmäßig an.
Für den Datenbank-Backlog sieht das ungefähr so aus:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: backlog-worker
spec:
  scaleTargetRef:
    name: backlog-worker
  minReplicaCount: 1        # ohne Angabe: 0
  maxReplicaCount: 5
  triggers:
    - type: postgresql
      metadata:
        connectionFromEnv: DB_URL
        query: "SELECT COUNT(*) FROM auftraege WHERE status = 'offen'"
        targetQueryValue: "500"
Rund 500 offene Datensätze pro Pod. Bei 1.200 offenen werden es drei.
Und jetzt Augen auf bei minReplicaCount. Lässt du es weg, gilt null. Ist eine Weile nichts zu tun (Standard: fünf Minuten), dreht KEDA den Hauptschalter um. Dein Worker ist weg. Wolltest du eigentlich nur einen zweiten Pod dazu? Tja. Überraschung, die keiner bestellt hat.
Der Charme von KEDA: Du schreibst YAML, keinen Code. Fertige Trigger für PostgreSQL, MySQL, Redis, Prometheus und Dutzende andere Quellen. Kein Go, kein Build, keine eigene Software, die du pflegen musst.
Wann ein eigener Controller
Jetzt der Satz, den kaum einer sagt: Wenn das Wissen im Team da ist, nimm einen selbstgebauten Controller.
Warum? Sonst stellst du dir einen ganzen Bauchladen in den Cluster, um am Ende eine einzige Zahl abzufragen. KEDA allein bringt Operator, Metrik-Server und Webhooks mit. Das wirkt schnell aufgebläht.
Dein eigener Controller ist dagegen der Hausmeister mit genau einer Aufgabe. Er guckt regelmäßig in den Keller, zählt die Kisten, holt Kollegen dazu oder schickt welche heim. Mehr nicht. Das ist seine Reconciliation Loop: nachsehen, vergleichen, Replicas setzen. Das einzige neue Teil im Cluster ist er selbst.
Zwei Dinge musst du ihm aber beibringen. Eine neue Zeile in der Datenbank löst in Kubernetes kein Ereignis aus, also sagst du ihm, dass er regelmäßig nachsehen soll. Und den Schutz gegen ständiges Hoch- und Runterspringen, den der HPA eingebaut hat, baust du selbst nach.
Am besten schreibst du ihn in Go, mit Kubebuilder und controller-runtime. Musst du aber nicht. Frameworks gibt es auch für andere Sprachen, etwa Kopf für Python oder das Java Operator SDK. Und nein, das ist kein Operator auf Vorrat. Skalieren nach Backlog ist genau so eine wiederkehrende Betriebsaufgabe, für die sich einer lohnt.
Der Haken: Controller-Entwicklung ist ein eigenes Handwerk. KEDA ist einfacher und weniger lernintensiv. Also frag dich zwei Dinge: Was kann dein Team? Und wo wollt ihr hin?
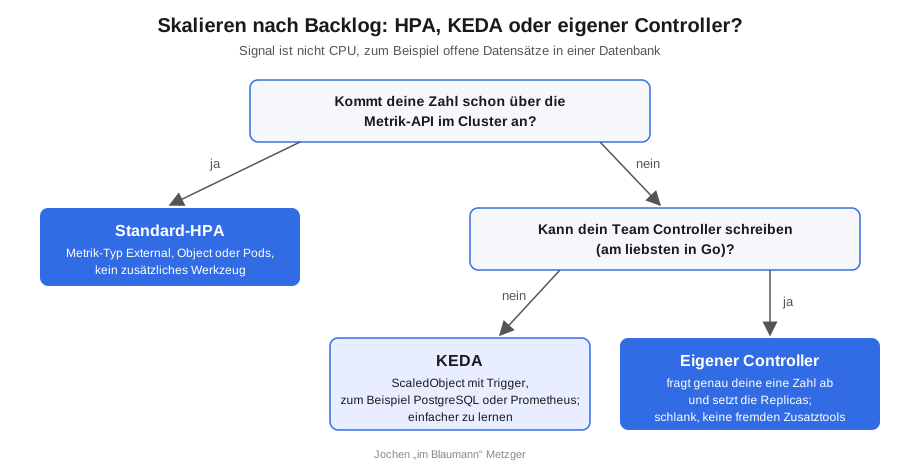
Meine Regel
Erst gucken, ob die Zahl schon da ist. Dann HPA.
Ist sie nicht da: KEDA, wenn ihr schnell ans Ziel wollt. Eigener Controller, wenn ihr Controller schreiben könnt. Dann bleibt der Cluster schlank, und an deinen Replicas dreht nur Code, den ihr selbst geschrieben habt.
Wie HPA und KEDA mit eigenen Metriken aus Prometheus zusammenspielen, bauen wir in meinem Training Kubernetes Advanced im Live-Cluster auf.