Das passende Training Kubernetes Advanced Training – Networking, Security, Observability & GitOps (3 Tage)
Ein Kubernetes-Cluster über zwei Rechenzentren ist selten die Hochverfügbarkeit, die ihr erwartet
Kurze Antwort: Zwei Rechenzentren heißen bei mir zwei Cluster.
Ein einziges Cluster über zwei Standorte strecken? Nur, wenn der Ping dazwischen unter zehn Millisekunden liegt. Und selbst dann kaufst du dir keine Ausfallsicherheit, sondern einen Münzwurf.
Zehn Millisekunden, meine wichtigste Regel
Wenn es im Training um Cluster über mehrere Rechenzentren oder Availability Zones geht, nenne ich als allerwichtigste Regel: höchstens zehn Millisekunden Ping zwischen den Standorten. Sonst wird etcd nach meiner Erfahrung zu langsam, und das ganze System wird spürbar zäh.
Warum gerade etcd? Da steht alles drin, was dein Cluster weiß. Und etcd ist ein Verein mit strenger Satzung: Keine Änderung gilt, bevor die Mehrheit der Mitglieder abgenickt hat. Kein Deployment, kein Pod-Update, keine Statusmeldung eines Nodes.
Der Flaschenhals ist dabei die Round-Trip-Zeit zum langsamsten etcd-Mitglied, dessen Stimme der Leader für die Mehrheit braucht. Sitzt dieses Mitglied im anderen Rechenzentrum, wartet jede Abstimmung auf die Leitung. Bei drei Mitgliedern reicht dem Leader zwar das schnellere der beiden anderen, aber verlass dich nicht drauf: Sitzt der Leader selbst drüben oder fällt bei dir ein Mitglied aus, geht jede Abstimmung über die Leitung. Und wo der Leader sitzt, kannst du nicht dauerhaft festnageln: Fällt er aus, wird neu gewählt.
Ping heißt übrigens hin und zurück. Die zehn Millisekunden sind also Round-Trip.
Ganz ehrlich: Das ist meine Faustregel aus der Erfahrung, kein Grenzwert aus der etcd-Doku. Die nennt gar keine feste Latenzgrenze, nur Stellschrauben. Red Hat erlaubt etcd in OpenShift sogar deutlich mehr. Die zehn Millisekunden tauchen dort nur in Sonderfällen auf: für einen Schiedsrichter-Standort (Arbiter) und wenn auch der Storage über die Rechenzentren gespannt wird (Details in der Tabelle unten).
Ich bleibe trotzdem bei zehn. Eine Regel, die auf einen Bierdeckel passt, merkt sich auch der Kollege, der das Netz plant.
Zwei Rechenzentren, drei Stimmen: Die Rechnung geht nicht auf
Selbst wenn die Leitung schnell genug ist, bleibt ein Rechenproblem. etcd braucht eine Mehrheit, bei drei Mitgliedern also zwei. Warum, habe ich beim Single-Node-Cluster erklärt.
Drei Mitglieder auf zwei Rechenzentren? Eins kriegt zwei, das andere eins. Gleichmäßig geht nicht.
Fällt das kleine aus: Glück gehabt, weiter geht’s. Fällt das große aus, sitzt das letzte Mitglied allein im Vereinsheim. Eine Stimme von drei, keine Mehrheit. Die Control Plane nimmt nichts mehr an, bis das große Rechenzentrum zurück ist oder jemand etcd von Hand wiederherstellt.
Und jetzt der Teil, den viele nicht auf dem Schirm haben: Ohne Mehrheit kannst du nicht mal mehr lesen. Nicht nur kubectl apply scheitert, auch kubectl get. Der API-Server fragt etcd nämlich so, dass die Antwort garantiert aktuell ist, und dafür braucht etcd einen Leader. Kein Leader ohne Mehrheit, keine Antwort.
Ich habe das nachgestellt, mit kind auf meinem Laptop. Drei Nodes, jeder davon Control Plane und Worker zugleich, so wie es viele für ihren kleinen HA-Cluster bauen:
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: zwei-rz
nodes:
- role: control-plane
- role: control-plane
- role: control-plane$ kind create cluster --config kind.yaml
$ kubectl taint nodes --all node-role.kubernetes.io/control-plane-
$ kubectl create deployment web --image=nginx:alpine --replicas=3Dann fallen zwei der drei Nodes aus, mein Rechenzentrum A. Auf dem dritten läuft der nginx-Pod weiter und antwortet brav:
$ docker stop zwei-rz-control-plane zwei-rz-control-plane2
$ docker exec zwei-rz-control-plane3 curl -s -o /dev/null -w "%{http_code}\n" http://10.244.2.2/
200
Aber frag mal den API-Server auf genau diesem Node:
$ kubectl --server=https://172.20.0.4:6443 --request-timeout=10s get pods
Unable to connect to the server: net/http: request canceled (Client.Timeout exceeded while awaiting headers)

$ kubectl --server=https://172.20.0.4:6443 --request-timeout=10s scale deployment web --replicas=5
Unable to connect to the server: context deadline exceeded (Client.Timeout exceeded while awaiting headers)
Ohne das Timeout wartet kubectl einfach ewig. Der Pod lebt, die Anwendung antwortet, aber du siehst nichts mehr und kannst nichts mehr ändern. Kaum sind die beiden Nodes zurück, antwortet der API-Server wieder, als wäre nichts gewesen.
Was im gesunden Rechenzentrum schon läuft, läuft in der Regel weiter. Aber Ersatz für die Pods aus dem ausgefallenen, etwa aus einem Deployment? Plant keiner ein. Genau in dem Moment, für den du das Ganze gebaut hast.
Vier Mitglieder, zwei pro Standort? Noch schlechter. Die Mehrheit liegt dann bei drei. Egal welches Rechenzentrum ausfällt, es bleiben zwei. Und reißt nur die Leitung ab, hat keine Seite eine Mehrheit.
Kopf: Das kleine Rechenzentrum fällt aus. Zahl: das große, und du stehst. Red Hat empfiehlt für gespannte Cluster deshalb drei Standorte, ein Control-Plane-Mitglied pro Standort.
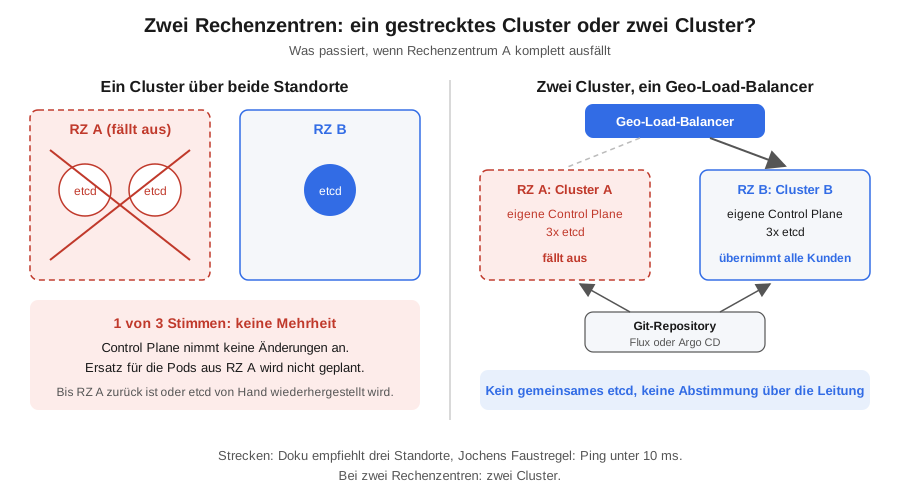
Mein Weg: zwei Cluster, ein Geo-Load-Balancer, Git
Ich würde erst mal den einfachen Weg nehmen. In jedem Rechenzentrum steht ein eigenes, vollständiges Cluster, mit eigener Control Plane und eigenem etcd. Zwei Vereine statt einem, jeder mit eigener Satzung.
Davor ein Geo-Load-Balancer. Der schaut, wo der Kunde herkommt, und lässt ihn beim Load Balancer des passenden Clusters landen.
Und wie kommt dieselbe Software auf beide Cluster, ohne dass einer durchdreht? Mit Flux oder Argo CD aus einem einzigen Git-Repository. Was da drinsteht, gilt für beide. Kein „Hab ich gestern mal eben drüben von Hand geändert“.
Fällt ein Rechenzentrum aus, schickt der Geo-Load-Balancer die Kunden zum anderen. Dafür muss er per Health Check merken, dass drüben keiner mehr antwortet. Arbeitet er über DNS, dauert das Umschalten so lange, wie die alten DNS-Antworten noch zwischengespeichert sind.
Das überlebende Cluster kriegt vom Ausfall nichts mit. Es musste nie mit dem anderen abstimmen.
Was das nicht löst: deine Daten. Eine Datenbank, die an beiden Standorten schreiben soll, ist eine eigene Baustelle. Die hast du beim gestreckten Cluster aber genauso, nur mit einem wackligen etcd obendrauf.
Was die Doku dazu sagt
| Quelle | Aussage |
|---|---|
| etcd-Doku, Tuning | Standard: Heartbeat 100 ms, Election Timeout 1.000 ms. Der Heartbeat soll sich an der Round-Trip-Zeit zwischen den Mitgliedern orientieren, der Election Timeout mindestens das Zehnfache der Round-Trip-Zeit betragen. |
| etcd-FAQ | Mehrheit bei n Mitgliedern: (n/2)+1. Drei Mitglieder verkraften einen Ausfall, vier ebenfalls nur einen. |
| Red Hat OpenShift 4.21, etcd-Performance | Mit Standard-Heartbeat (100 ms) empfohlen: unter etwa 33 ms Round-Trip zwischen den Control-Plane-Nodes, höchstens unter 66 ms. Ein Arbiter-Standort soll unter 10 ms Round-Trip liegen. |
| Red Hat OpenShift 4.21, Cluster über Rechenzentren | Disk- und Netzlatenz samt Jitter müssen die etcd-Round-Trip-Zeit unter 100 ms halten. Über Rechenzentren gespannte Cluster mit dem Storage OpenShift Data Foundation: unter 10 ms Round-Trip. Empfohlen sind drei Standorte. |
| Red Hat, wörtlich | „Do not deploy an OpenShift Container Platform cluster that spans many sites. If you need presence in many data centers or regions, deploy one cluster per region or site …“ |
| Kubernetes-Doku, mehrere Zonen | Ein Cluster kann über mehrere Zonen laufen, typischerweise innerhalb einer Region. Ist Verfügbarkeit wichtig, die Control Plane über mindestens drei Zonen verteilen. |
Und Availability Zones?
Für Zonen gilt dieselbe Regel. Es zählt der Ping, nicht das Schild an der Tür.
Meine persönliche Einschätzung: Ich lasse jedes Cluster lieber in einer Zone und kopple bei Bedarf zwei Cluster, statt eines über zu große Distanzen zu strecken. Die Kubernetes-Doku beschreibt zwar Cluster über mehrere Zonen einer Region. Ist Verfügbarkeit wichtig, soll die Control Plane aber auf mindestens drei Zonen verteilt sein. Zwei Zonen haben dasselbe Mehrheitsproblem wie zwei Rechenzentren.
Und wenn zwischen deinen beiden Rechenzentren eine schnelle Glasfaser liegt, deutlich unter zehn Millisekunden? Dann ginge ein gestrecktes Cluster technisch. Ich baue trotzdem zwei. Die müssen sich im Betrieb nichts erzählen, beide lesen nur dasselbe Git-Repository.
Wie eine Control Plane mit mehreren Nodes aufgebaut ist und wie GitOps mit Flux einen Cluster aus Git baut, üben wir im Training Kubernetes Advanced am Live-Cluster.