Das passende Training Kubernetes Einführung Training – 3 Tage Praxis mit Live-Cluster
Longhorn ist langsam und wird trotzdem eingesetzt. Wann das okay ist
Kurze Antwort: Longhorn ist mit drei Replikaten (drei Kopien auf drei Maschinen) beim Schreiben drei- bis viermal langsamer als ein Block-Volume deines Cloud-Anbieters. Wo niemand auf den Speicher wartet, ist das egal. Wartet jemand, zum Beispiel eine Datenbank, dann nicht.
Im Einführungstraining sage ich: Persistenter Speicher gehört außerhalb des Clusters, weil Speicher im Cluster meist nicht schnell genug ist. Longhorn ist langsam, und es wird trotzdem eingesetzt, weil es für manche Anwendungen keine Rolle spielt. Das höre ich von Kunden und anderen Dienstleistern genauso. Nur: Ich wollte Zahlen. Also hab ich gemessen.
Was ist was?
- Longhorn ist ein freies Speicher-System, das selbst in Kubernetes läuft (ein Projekt der CNCF, ursprünglich von Rancher). Es nimmt die Platten der Maschinen im Cluster und macht daraus Volumes für deine Pods, auf Wunsch mit mehreren Kopien (Replikaten) auf verschiedenen Maschinen.
- Block Storage ist Speicher in Blöcken: ein Datenträger ohne Ordner und Dateien. Dein Server legt ein Dateisystem darauf und nutzt ihn wie eine eingebaute Platte. Ein Block-Volume ist so ein Datenträger, den dein Cloud-Anbieter übers Netzwerk an die Maschine hängt. Longhorn ist selbst auch Block Storage, nur eben im Cluster.
- Ein NFS-Server gibt dagegen fertige Ordner und Dateien übers Netzwerk frei, sodass mehrere Maschinen dieselben Dateien nutzen können.
Was ich gemessen habe
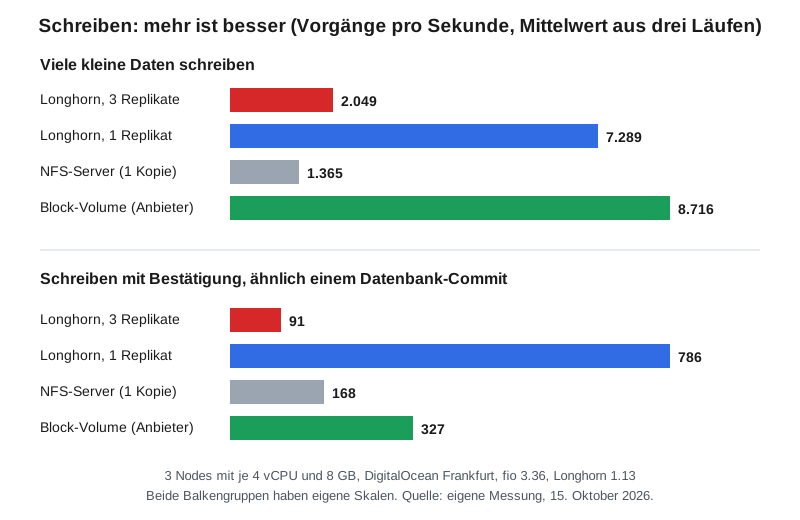
Drei Maschinen bei DigitalOcean mit Longhorn. Dagegen ein NFS-Server, den ich selbst aufgesetzt habe, und ein Block-Volume vom Anbieter. Gemessen habe ich mit fio, einem freien Werkzeug, das Speicher so lange mit Lese- und Schreibvorgängen quält, bis er Zahlen liefert. Jeder Test lief dreimal, die Tabelle zeigt Mittelwerte. Mehr ist besser.
| Was wird gemacht | Longhorn, 3 Replikate | Longhorn, 1 Replikat | NFS-Server | Block-Volume |
|---|---|---|---|---|
| Viele kleine Daten schreiben (pro Sekunde) | 2.049 | 7.289 | 1.365 | 8.716 |
| Schreiben mit Bestätigung, ähnlich einem Datenbank-Commit (pro Sekunde) | 91 | 786 | 168 | 327 |
| Große Dateien lesen (MiB pro Sekunde, grob Megabyte) | 110 | 105 | 220 | 449 |
„Mit Bestätigung“ heißt: Nach jedem Schreiben wartet das Programm, bis die Daten wirklich auf der Platte sind (fsync). Das tut eine Datenbank bei jedem Commit, mein Test kommt dem am nächsten.
Was mich überrascht hat
Bei kleinen Schreibvorgängen kosten die drei Kopien das Tempo. Mit nur einem Replikat schreibt Longhorn dabei fast so schnell wie das Block-Volume, beim Schreiben mit Bestätigung sogar schneller. Das liegt wohl zum Teil auch daran, dass die Daten dann auf derselben Maschine liegen. Dafür gibt es keinen Ausfallschutz mehr: Fällt die Maschine aus, sind die Daten nicht erreichbar. Bei großen Dateien ist Longhorn auch mit einem Replikat langsamer als das Block-Volume. Beim Lesen sind es 105 gegen 449, beim Schreiben 179 gegen 334 MiB pro Sekunde.
Ein NFS-Server außerhalb des Clusters ist nicht automatisch schneller. Mein Rat im Training war bisher: Speicher raus aus dem Cluster. Für einen selbst aufgesetzten NFS-Server rückt die Messung das zurecht. Er war beim Lesen und bei großen Dateien besser als Longhorn mit drei Replikaten. Bei vielen kleinen Schreibvorgängen war kein Unterschied zu erkennen. Gegen das Block-Volume verlor er beim Schreiben überall.
Was nimmst du wann?
- Niemand wartet auf den Speicher (Ablagen, selten geänderte Daten): Longhorn mit drei Replikaten. Du bekommst Ausfallschutz und lebst mit dem Tempo.
- Eine Datenbank wartet bei jedem Speichern: ein Block-Volume deines Anbieters. 91 gegen 327 spürst du.
- Mehrere Pods müssen gleichzeitig auf dieselben Dateien (ReadWriteMany): Ein Block-Volume kann das bei DigitalOcean nicht, es hängt nur an einer Maschine. Ein NFS-Server geht. Beim Schreiben war er in meinem Test aber nicht durchgehend schneller als Longhorn. Miss es für deinen Fall.
Ob eine Datenbank überhaupt in den Cluster gehört, ist eine eigene Frage: Datenbank im Cluster: Die Operator-Frage kommt zu früh.
Das ist ein Schnappschuss auf meinem Setup, keine Doktorarbeit. Bei dir kann es anders aussehen. Miss nach, bevor du dich auf eine Zahl aus dem Internet verlässt, auch auf meine.
Wie du Volumes und Persistent Volumes in Kubernetes einrichtest, üben wir in meinem Training Kubernetes Einführung.