Das passende Training Microservices Training – Architektur, Docker und Kubernetes in 5 Tagen
Mehrere Threads im Pod oder lieber mehr Pods? Die Speichergrenze entscheidet
Im Einführungstraining kam diese Frage von einem Teilnehmer. In seinem System liegen die offenen Aufgaben in Redis, beispielsweise fünftausend. Mehrere Pods holen sich dort Aufgaben ab und erledigen sie, und etwa tausend davon sollen wirklich gleichzeitig laufen. Seine Frage: Ein Pod pro Aufgabe? Oder ein Pod, der gleich eine Reihe von Aufgaben in Threads abarbeitet, lauter kleine Miniprozesse? Und was ist in Kubernetes Best Practice?
Kurze Antwort: Der Normalfall ist mehr Pods. Das ist einfacher, und Kubernetes ist dafür gebaut. Sollen aber tausend Aufgaben gleichzeitig laufen und kannst du nicht tausend Pods starten, nimm Threads im Container.
Aber dann gilt eine Regel ohne Ausnahme. Du musst wissen, wie viel Speicher ein Thread frisst. Und danach rechnest du das Memory-Limit. Sonst kommt der OOM-Killer. Und der kommt wieder. Und wieder.
Mein Kollege und meine API
Im Einführungstraining Ende September hab ich zwei Geschichten nebeneinandergestellt.
Die erste: Ein Kollege hat sich ganz bewusst gegen mehrere Threads entschieden. Sein Service arbeitet die Anfragen schön der Reihe nach ab, eine nach der anderen. Wird’s mehr, kommt ein zweiter Pod dazu. Spektakulär? Nö. Aber sein Pod verarbeitet immer nur eine Anfrage gleichzeitig, nicht hundert.
Die zweite ist meine eigene. Ich hatte mal eine API gebaut, in der mehrere Threads gleichzeitig liefen. Fühlte sich schlau an. Bis die Anwendung an die Speichergrenze stieß und der OOM-Killer eingegriffen hat. Der Grund: Ich hatte den Speicherbedarf pro Thread nicht richtig bemessen.
Ganz ehrlich: Mein Kollege hatte an der Stelle weniger Arbeit als ich.
Ein Prozess, alle Threads, ein Schicksal
Warum ist der Speicher so gnadenlos? Weil das Memory-Limit für den ganzen Container gilt. Alle Threads essen aus demselben Topf, und gezählt wird die Summe.
Wer greift da eigentlich durch? Nicht Kubernetes, sondern der Linux-Kernel. Das Memory-Limit ist eine Grenze, die er für den Container durchsetzt. Wird sie überschritten, springt der OOM-Killer an (OOM steht für „Out Of Memory“): Er beendet einen Prozess sofort, ohne Vorwarnung und ohne Aufräumen. Kubernetes sieht nur das Ergebnis, nämlich OOMKilled und Exit-Code 137.
Läuft der Topf über, kann der Kernel keinen einzelnen Thread rauswerfen. Er beendet ganze Prozesse. Und deine API ist nun mal ein Prozess. Also sind alle Threads weg, mit allen Anfragen, die gerade unterwegs waren. Wie die Sicherung für deine Wohnung: Die fliegt nicht wegen des Wasserkochers raus, sondern wegen der Summe aller Geräte. Und dann ist in allen Zimmern das Licht aus.
Dann startet Kubernetes den Container neu. Gleiche Last, gleiche Threads, gleiche falsche Rechnung. Also wieder OOMKilled. Ich nenne das Selbstheilung für Arme: Die Hoffnung stirbt zuletzt, beim nächsten Mal wird’s schon klappen. Wird’s nicht. Der Restart-Zähler läuft hoch, und die Pausen zwischen den Neustarts werden länger.
Nachgestellt: 1000 Threads, ein Gigabyte
Ich hab das nachgebaut, mit einem kleinen Python-Worker auf einem lokalen kind-Cluster (Kubernetes 1.37). Er holt Aufgaben aus Redis, tausend Threads parallel, jede Aufgabe hält ein Megabyte im Speicher. Gemessen mit großzügigem Limit: 24 MiB Grundbedarf und 1081 MiB bei tausend Threads, also gut ein MiB pro Thread. Das ist nur ein Megabyte Nutzdaten plus etwas Overhead. Python gibt dir keinen Wert, der für jede Sprache gilt.
Mit 1024 Mi („tausend mal ein Megabyte, passt“) sieht es so aus:
$ kubectl describe pod geraten | grep -E "Reason|Exit Code|Restart Count"
      Reason:       OOMKilled
      Exit Code:    137
    Restart Count:  4
$ kubectl get events --field-selector involvedObject.name=geraten
Warning   BackOff   pod/geraten   Back-off restarting failed container worker
Mit 1200 Mi, nach der Formel gerechnet, lief derselbe Pod durch: Spitze 1084 MiB, null Neustarts.
Und die CPU? Die ist beim Thread-Weg das kleinere Problem. Zu wenig CPU, und deine Threads schleichen. Zu wenig Speicher, und sie sind weg. Langsam kannst du reparieren. Weg ist weg.
Wann Threads im Pod trotzdem richtig sind
Jetzt die andere Seite. Zurück zu der Warteschlange mit fünftausend Aufgaben, von denen tausend gleichzeitig laufen sollen. Nach der Methode meines Kollegen: tausend Pods.
Das geht, ist aber kein Spaziergang. Kubernetes ist für höchstens 110 Pods pro Node ausgelegt, so steht’s auch als Standard im Kubelet. Auf die 110 zählen auch die Systempods jeder Node. Macht mehr als 10 Nodes, nur damit jeder Pod ein Bett hat. Und jeder bringt seinen eigenen Prozess mit eigenem Grundbedarf mit. Kannst du nur eine begrenzte Zahl Pods laufen lassen, etwa wegen einer Quota oder der Clustergröße, ist das Thema durch.
Dann sind Threads in einem Container die richtige Wahl. Aber bevor du das Limit hinschreibst, kommt die Faustformel auf den Tisch:
Memory-Limit = Grundbedarf + Zahl der Threads × Speicher pro Thread + Puffer
Speicher pro Thread heißt: was ein Thread für seine Arbeit in der Spitze belegt. Nicht im Mittel. Und in den Puffer gehört alles, was sich keinem Thread zuordnen lässt.
Klingt nach Mathe in der siebten Klasse. Ist es auch. Aber guck dir an, was ein kleiner Fehler anrichtet. Tausend Threads in einem Pod. Ein Megabyte pro Thread zu knapp geschätzt. Macht ein Gigabyte, das dir fehlt. Da ist nichts mehr mit „wird schon passen“.
Und die Rechnung geht nur auf, wenn die Zahl der Threads einen festen Deckel hat. Ein Pool, der unter Last ohne Obergrenze weiterwächst, macht aus jeder Formel ein Ratespiel.
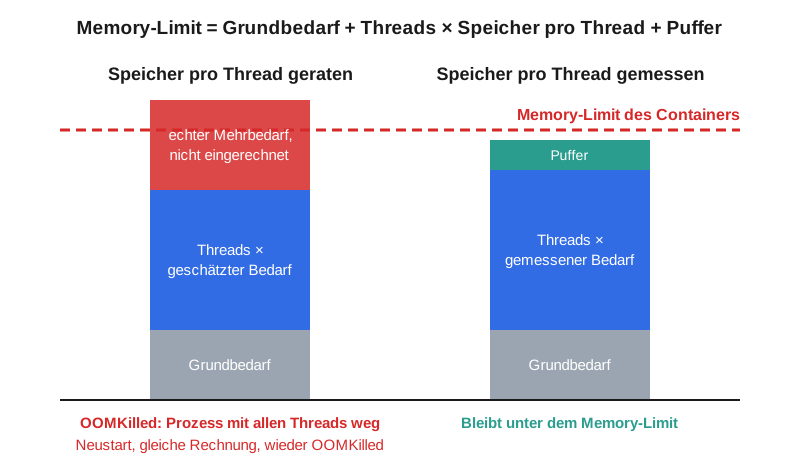
Knapp ist gut. Geraten nicht.
Ich sag im Training sonst immer: Gib einzelnen Pods lieber wenig als zu viel, damit sie flexibel auf verschiedenen Nodes laufen können. Der Scheduler plant nach den Requests, und kleine Pods passen fast überall hin. Dazu stehe ich.
Beim Memory-Limit heißt knapp aber: knapp gerechnet. Nicht geraten. Das Limit muss tragen, was deine Threads in der Spitze zusammen brauchen. Und den Speicher pro Thread kennst du erst, wenn du ihn gemessen hast. Erst dann setzt du das Limit.
| Fakt aus der Doku | Was das für deine Threads heißt | Quelle |
|---|---|---|
| „memory limits are enforced reactively“ … „A container may use more memory than its memory limit, but if it does, it may get killed.“ | Standardmäßig keine Bremse beim Speicher; wer drüber ist, riskiert den OOMKill | Kubernetes-Doku, Resource Management for Pods and Containers |
| CPU-Limits setzt der Kernel per Drosselung durch | Zu wenig CPU macht Threads langsam, beendet werden sie dafür nicht | ebenda |
| Ausgelegt für höchstens 110 Pods pro Node | Tausend Pods brauchen beim Standardwert mehr als 10 Nodes, weil auch Systempods mitzählen | Kubernetes-Doku, Considerations for large clusters |
Meine Regel
Wenige parallele Aufgaben: mach’s wie mein Kollege. Pods, die ihre Aufgaben der Reihe nach abarbeiten, bei Bedarf ein Pod mehr. Liegen die Aufgaben in einer Warteschlange wie Redis, kann die Zahl der Pods der Länge folgen. Wie das mit KEDA geht und wann ein eigener Controller schlanker ist, steht im Artikel Der HPA kann mehr als CPU, nur nicht von allein. Allgemein zum Autoscaling: HPA und VPA.
Tausend gleichzeitige Aufgaben und nur begrenzt Pods: Threads im Container. Aber erst messen, dann rechnen, dann das Limit setzen. Wer den Speicher pro Thread rät, baut sich eine Neustartschleife mit Ansage.
Wie du so einen Service schneidest, in einen Container packst und mit passenden Ressourcen in Kubernetes ausrollst, bauen wir in meinem Training Microservices mit Docker und Kubernetes an einem durchgängigen Beispielprojekt.