Das passende Training Kubernetes Einführung Training – 3 Tage Praxis mit Live-Cluster
Selbstheilung für Arme: Warum Kubernetes deinen abstürzenden Container einfach immer wieder startet
Ganz ehrlich: Das ist keine Selbstheilung. Das ist Hoffnung mit Zeitschaltuhr.
Kubernetes startet deinen abgestürzten Container neu, ohne nach dem Warum zu fragen. Bei einem kurzen Schluckauf reicht das. Meiner Erfahrung nach steckt aber meistens ein echtes Problem dahinter. Dann startet der Container wieder und wieder. Und läuft nie.
Der steigende Restart-Zähler ist kein Heilungsprozess. Er ist dein Arbeitsauftrag.
Was Kubernetes da eigentlich „heilt“
Die Kubernetes-Doku nennt das ganz stolz „Self-healing“. Gleich der erste Halbsatz: „Kubernetes restarts containers that fail“. Der Neustart ist dort nur ein Teil des Versprechens (dazu kommen Austausch von Containern und Health Checks), aber der Teil, um den es hier geht. Selbstheilung! Das ist ungefähr so heilend wie die Hotline, die fragt: „Haben Sie es schon mal aus- und wieder eingeschaltet?“
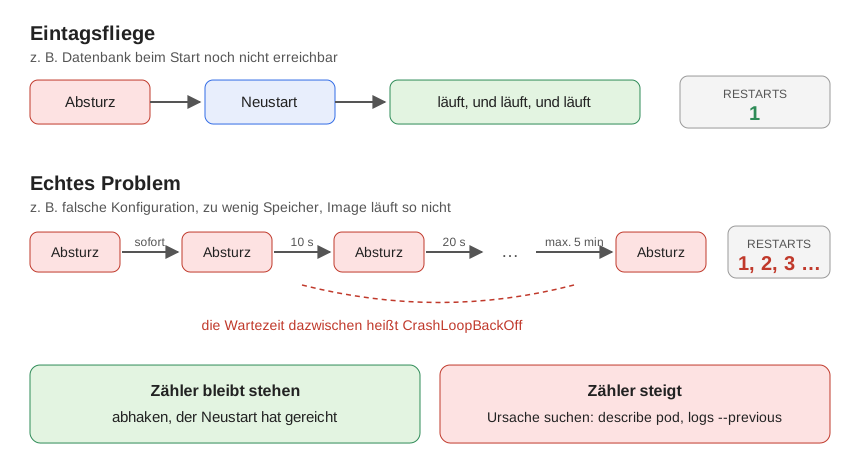
Genau das passiert. Der kubelet auf dem Node merkt, dass der Container weg ist, und startet ihn neu. Kippt er wieder um, wartet der kubelet etwas länger, dann noch länger. Diese Warteschleife heißt CrashLoopBackOff. Kein eigener Fehler, sondern Kubernetes beim Däumchendrehen.
In meinen Einführungstrainings nenne ich das „Selbstheilung für Arme“. Die Hoffnung stirbt zuletzt: Beim nächsten Mal wird’s schon klappen.
Wann der Neustart wirklich hilft
Klar, manchmal ist der Neustart die Rettung. Die Datenbank hat beim Start noch gepennt, ein Dienst kam eine Sekunde zu spät aus dem Bett. Zack, zweiter Versuch, Kiste läuft, der Zähler bleibt bei 1.
Für so eine Eintagsfliege ist der automatische Neustart ein prima erster Schritt. Verlass dich nur nicht drauf.
Meistens ist es kein Schnupfen
Ist es ein echtes Problem, ist der Grund für den Absturz beim zweiten Start immer noch da. Und beim dritten. Und beim zweihundertsten.
Ich hatte eine Helm-Schulung bei einem großen Finanzinstitut, OpenShift-Umgebung. Standard-nginx-Image, ganz normale Übung. Der Pod kam nicht hoch: CrashLoopBackOff. Der Grund: OpenShift lässt Container standardmäßig nicht als Root laufen, sondern mit einer vom Projekt vergebenen User-ID, und das Standard-nginx-Image kommt damit nicht klar. Die ganze Geschichte steht in meinem Artikel über das Root-Verbot von OpenShift. Hier zählt nur: Die Ursache steckte im Image, nicht im Zufall. Daran ändert auch der tausendste Neustart nichts.
Zweites Beispiel, diesmal mein eigener Mist. Ich hab mal eine API gebaut, die mehrere Anfragen gleichzeitig in eigenen Threads abgearbeitet hat. Irgendwann stieß sie an ihre Speichergrenze, und der OOM-Killer hat zugeschlagen. Der Speicherbedarf pro Thread war schlicht falsch bemessen. So ein Fehler sitzt im Code. Ein frischer Container bringt denselben Code mit und rennt gegen dieselbe Wand.
Der Zähler ist dein Auftrag
Deshalb: Schau bei kubectl get pods nicht nur auf STATUS, sondern auf RESTARTS. Steht da eine 1 und bewegt sich tagelang nicht, war es eine Eintagsfliege. Zählt die Zahl weiter, hörst du auf zu hoffen und fängst an zu suchen.
Dafür brauchst du drei Griffe: get pods, describe, logs. Die üben wir im Training, bis sie Reflex sind (Karate Kid lässt grüßen). Zwei Kniffe dabei:
kubectl describe pod <name>zeigt unter „Last State“, wie der Container zuletzt gestorben ist, zum BeispielOOMKilled.kubectl logs <name> --previousholt die Logs der vorherigen Instanz. Hat die Anwendung vor dem Absturz noch was gesagt, steht es da.
Und jetzt der fiese Teil. Der gefährlichste Pod ist der, der dich grün anlächelt. Läuft ein Container zehn Minuten sauber, vergisst der kubelet die Strafzeit. Stürzt er nur jede Stunde einmal ab, siehst du nie CrashLoopBackOff, sondern fast immer brav Running. Nur RESTARTS klettert. Und klettert. Das ist dein stiller Alarm.
Noch was: Rollst du eine neue Version aus, kommen neue Pods, und die fangen beim Zähler wieder bei 0 an. Ohne zentrales Logging sind die Logs der alten Pods gleich mit weg. Damit ist dein Beweis futsch. Also erst Ursache sichern, dann ausrollen.
Der Fahrplan laut Kubernetes-Doku
| Was | Verhalten (Standard) | Quelle |
|---|---|---|
| Absturz | erster Neustart sofort, danach Wartezeit 10 s, 20 s, 40 s … | Kubernetes-Doku, „Pod Lifecycle“ |
| Obergrenze | 300 Sekunden, also 5 Minuten; seit Kubernetes 1.35 (Beta) pro Node über die kubelet-Konfiguration niedriger einstellbar | Kubernetes-Doku, „Pod Lifecycle“ |
| Zurücksetzen | nach 10 Minuten ohne Probleme beginnt die Wartezeit von vorn | Kubernetes-Doku, „Pod Lifecycle“ |
| Restart-Zähler | zählt die Neustarts des Containers in diesem Pod; ein neuer Pod beginnt bei 0, nach einem Node-Neustart kann der Wert auf 0 fallen | Kubernetes-API, Feld restartCount |
| Beispiel aus der Doku | ein Pod in CrashLoopBackOff mit 200 Neustarts, Alter 2 Tage und 9 Stunden | Kubernetes-Doku, „Pod Lifecycle“ |
Meine klare Ansage
Ein Neustart ist erste Hilfe, keine Heilung. Lass Kubernetes ruhig den ersten Versuch machen. Aber sobald der Zähler weiterläuft, ist Schluss mit Hoffen.
Wie du die Ursache dann findest, bis es im Schlaf sitzt, üben wir in meinem Training „Kubernetes Einführung“ am Live-Cluster.