Das passende Training Kubernetes Advanced Training – Networking, Security, Observability & GitOps (3 Tage)
Wie groß sollten Kubernetes-Nodes sein? Viele kleine oder wenige große VMs
Kurze Antwort: in der Mitte. Bei wenigen dicken Nodes geht zu viel Platz für die Ausfallreserve drauf, bei winzigen zu viel für den Grundverbrauch jeder einzelnen VM. Wo genau die Mitte liegt, rechnest du aus deinem Bedarf aus.
Im Training sage ich: Viele kleine Maschinen sind besser als wenige große. Das ist mein Bauchgefühl, zu neunundneunzig Prozent bin ich mir sicher. Für das eine Prozent gibt’s hier die Rechnung.
Ich gehe von VMs aus. Wo sie laufen, ist egal.
Ausgangspunkt: Was brauchen deine Pods?
Addiere die Requests aller Pods, nicht die Limits. In unserem Beispiel sind das 60 GiB Arbeitsspeicher. Mit der CPU rechnest du genauso, getrennt vom Arbeitsspeicher.
Dann zwei Festlegungen:
- Mindestens drei Nodes. Warum, steht im Artikel zum Single-Node-Cluster in der Produktion. Die drei VMs laufen idealerweise auf verschiedenen Hosts.
- Ein Node darf ausfallen. Das ist meine Annahme, keine Kubernetes-Regel. Kubernetes hält von Hause aus nicht einfach etwas für dich frei. Fehlt der Platz, bleiben die Pods im Status
Pending. Gemeint ist eine VM, die ausfällt oder für Wartung geleert wird. Fällt ein ganzer Host mit mehreren VMs aus, brauchst du mehr Reserve. Das rechne ich hier nicht.
Zwei Dinge kosten dich Platz
Die Ausfallreserve. Fällt ein Node aus (Hardware, Kernel-Update, kubectl drain), müssen seine Pods auf die anderen passen. Die anderen Nodes müssen also zusammen auch den Bedarf des ausgefallenen Nodes tragen können. Der freie Platz sitzt verteilt, jeder Node bleibt ein Stück leer. Bei drei Nodes ist das ein Drittel von allem, bei sechs ein Sechstel.
Der Grundverbrauch. Jeder Node hat einen Grundverbrauch, bevor überhaupt Pods deiner Applikation dort laufen können: Betriebssystem, kubelet, Container-Runtime, dazu die DaemonSets, die auf jedem Node sitzen. Ich rechne im Beispiel mit 2 GiB je VM. Das ist eine Annahme. Die GKE-Doku zu Node-Größen reserviert bei Nodes von 8 bis 32 GiB zwischen 1,9 und 2,2 GiB für Betriebssystem, kubelet, Container-Runtime und die Eviction-Schwelle. Dazu kommen die Requests deiner System-DaemonSets (typischerweise kube-proxy und der Agent deines CNI-Providers) und von System-Deployments wie CoreDNS. Die rechne ich hier nicht mit. Bei dir misst du den Wert.
Die Reserve wird kleiner, wenn du mehr Nodes hast. Der Grundverbrauch wird größer. Genau da liegt der Sweet-Spot.
Die Rechnung
Jeder Node muss nach einem Ausfall mit seinen Kollegen 60 GiB tragen. Bei sechs Nodes bleiben fünf übrig, jeder muss also 60 ÷ 5 = 12 GiB nutzbar haben, plus 2 GiB Grundverbrauch: eine VM mit 14 GiB. Sechs davon sind 84 GiB.
Dasselbe für andere Anzahlen, alles in GiB RAM:
| Nodes | Größe je VM | Reserve | Grundverbrauch | Gesamt-RAM | Mehr als der Bedarf |
|---|---|---|---|---|---|
| 3 | 32 | 30 | 6 | 96 | +60 % |
| 6 | 14 | 12 | 12 | 84 | +40 % |
| 9 | 9,5 | 7,5 | 18 | 85,5 | +43 % |
| 12 | 7,5 | 5,5 | 24 | 89,5 | +49 % |
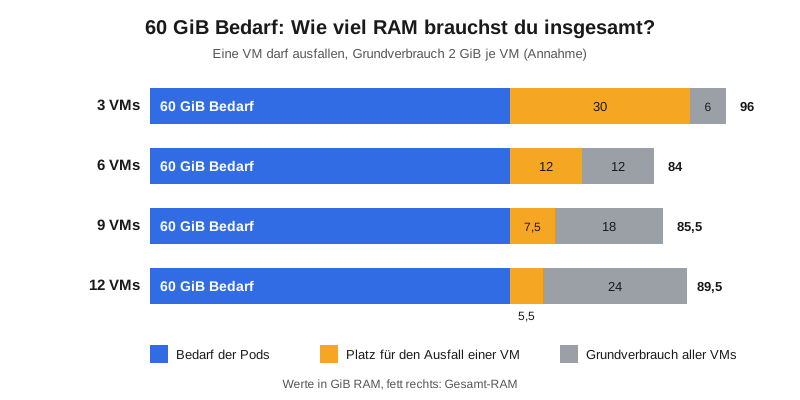
Drei Nodes sind klar am schlechtesten: Die Reserve ist ein Drittel von allem, der Grundverbrauch fällt kaum ins Gewicht. Bei zwölf ist es umgekehrt. Zwischen sechs und neun ist der Unterschied klein. Der Sweet-Spot ist also kein einzelner Wert, sondern ein Bereich: Sechs bis neun Nodes sind fast gleich gut.
Der Rechenweg ist für jede Menge derselbe: Bedarf ÷ (Nodes − 1) + Grundverbrauch ergibt die Größe, mal Anzahl ergibt die Gesamtmenge. Probier verschiedene Anzahlen aus und nimm die mit dem kleinsten Gesamt-RAM.
Das ist die freundliche Variante. Mit größerem Grundverbrauch, etwa durch dicke DaemonSets, rutscht der beste Bereich zu weniger, größeren Nodes.
Die leeren Nodes, über die sich keiner freut
In einem Training beschwerte sich mal ein Teilnehmer: „Mir gefällt das nicht. Ich habe ganz viele Nodes, und die letzten drei sind komplett leer. Da läuft gar nichts drauf."
Meine Antwort: Ist kein Fehler, ist Kubernetes. Pods, die schon laufen, verteilt der Scheduler nicht neu, nur weil Nodes dazukommen. Er entscheidet nur, wenn ein Pod neu eingeplant wird. Nachhelfen kannst du, aber dann arbeitest du gegen Kubernetes statt mit ihm. Freier Platz sieht nach Verschwendung aus, ein Stück Luft brauchst du aber sowieso.
Gegenproben, bevor du bestellst
- Der dickste Pod muss auf eine VM passen, samt DaemonSets. Sonst bleibt er
Pending, egal wie viel Platz das Cluster hat. - Die Grenze von 110 Pods pro Node. Der kubelet macht standardmäßig dort die Tür zu, die Kubernetes-Doku zu großen Clustern plant mit dieser Zahl. Ein 64-GiB-Node mit Pods à 256 MiB ist nach 110 Pods voll, das sind höchstens 27,5 GiB. Den Rest kannst du nicht nutzen.
- Die CPU rechnest du genauso und getrennt vom RAM. Die Anzahl Nodes muss bei beiden Werten aufgehen. Zeigen sie auf verschiedene Anzahlen, gilt die höhere.
Meine klare Ansage
Wenige große Nodes? Nein. Beliebig kleine auch nicht. Schreib deinen Bedarf auf, rechne es für drei, sechs, neun und zwölf Nodes aus und nimm die Anzahl mit dem kleinsten Gesamt-RAM. Dann prüf die Gegenproben.
Das Bauchgefühl hat die Rechnung überlebt, jedenfalls gegen die wenigen Großen. Gegen beliebig kleine Nodes nicht. Das war das eine Prozent.
Wie Requests, Autoscaling und Nodes im echten Cluster zusammenspielen, üben wir im Training Kubernetes Advanced am Live-Cluster.